38. A Mathematical Analysis of Tournament Selection
Los Algoritmos Genéticos (AG) son algoritmos de búsqueda probabilísticos caracterizados por el hecho de que un número de soluciones potenciales (llamadas individuos , donde representa el espacio de todos los individuos posibles) del problema de optimización muestrean simultáneamente el espacio de búsqueda. Esta población se modifica según el proceso evolutivo natural: después de la inicialización, la selección y la recombinación se ejecutan en un bucle hasta alcanzar algún criterio de terminación. Cada ejecución del bucle se denomina generación y denota la población en la generación .
El operador de selección tiene como objetivo mejorar la calidad media de la población otorgando a los individuos de mayor calidad una mayor probabilidad de ser copiados en la siguiente generación. De este modo, la selección enfoca la búsqueda en regiones prometedoras del espacio de búsqueda. La calidad de un individuo se mide mediante una función de aptitud . La recombinación cambia el material genético en la población mediante el cruce o la mutación para explotar nuevos puntos en el espacio de búsqueda. El equilibrio entre la explotación y la exploración puede ajustarse mediante la presión de selección del operador de selección o mediante el operador de recombinación, por ejemplo, mediante la probabilidad de cruce. Dado que este equilibrio es crítico para el comportamiento del AG, es de gran interés conocer las propiedades de los operadores de selección y recombinación para comprender su influencia en la velocidad de convergencia.
Un análisis basado únicamente en el comportamiento del mejor individuo o en la aptitud media de la población solo describe un pequeño aspecto de un método de selección. En este artículo, un esquema de selección se describe por su interacción con la distribución de los valores de aptitud. Esta descripción se introduce en la siguiente sección. En la Sección 3 se realiza un análisis de la selección por torneo y en la Sección 4 se derivan sus propiedades. La Sección 5 compara la selección por torneo con otros métodos.
2 DESCRIPCIÓN DE LOS ESQUEMAS DE SELECCIÓN
En general, el comportamiento de un esquema de selección depende únicamente de los valores de aptitud (fitness) de los individuos de la población. En este artículo describimos un esquema de selección utilizando la distribución de aptitud antes y después de la selección. De este modo, se asume que la selección y la recombinación se realizan secuencialmente: primero, una fase de selección crea una población intermedia y luego se realiza la recombinación con una cierta probabilidad sobre los individuos de esta población intermedia para obtener la población de la siguiente generación. Este tipo de descripción difiere de los paradigmas comunes donde la selección se hace para obtener los individuos para la recombinación ([Goldberg, 1989; Koza, 1992]). Pero es matemáticamente equivalente y permite analizar el método de selección por separado.
Definición 2.1 (Distribución de aptitud) La función asigna a cada valor de aptitud el número de individuos en una población que poseen este valor de aptitud. se denomina distribución de aptitud de una población .
Definición 2.2 (Distribución de aptitud acumulada) Sea el número de valores de aptitud únicos y () el ordenamiento de los valores de aptitud, donde denota la peor aptitud presente en la población y denota la mejor aptitud.
denota el número de individuos con valor de aptitud o peor y se denomina distribución de aptitud acumulada, es decir:
Con estas definiciones, un método de selección puede describirse como una función que transforma una distribución de aptitud en otra distribución de aptitud.
Definición 2.3 (Método de selección) Un método de selección es una función que transforma una distribución de aptitud en una nueva distribución de aptitud :
es una lista opcional de parámetros del método de selección.
Definición 2.4 (Distribución de aptitud esperada) _\Omega^_ denota la distribución de aptitud esperada después de aplicar el método de selección a la distribución de aptitud , es decir:*
se utiliza como abreviatura.
Con esta notación, no solo se puede describir el comportamiento del mejor individuo de la población o el valor de aptitud promedio, sino todos los aspectos de un esquema de selección. Nuestro objetivo es predecir a partir de la distribución de aptitud dada . En la siguiente sección queremos derivar esta predicción para la selección por torneo.
3 SELECCIÓN POR TORNEO
La selección por torneo funciona de la siguiente manera: se elige un número de individuos al azar de la población y se copia al mejor individuo de este grupo en la población intermedia, y se repite veces. A menudo los torneos se realizan solo entre dos individuos (torneo binario), pero es posible una generalización a un tamaño de grupo arbitrario llamado tamaño del torneo.
Para los siguientes cálculos, asumimos que la selección por torneo se realiza con reemplazo.
Teorema 3.1 _La distribución de aptitud esperada \Omega_T^_(s, t) después de realizar la selección por torneo con tamaño de torneo sobre la distribución es*
Prueba: Primero calculamos el número esperado de individuos con aptitud o peor, es decir, . Un individuo con aptitud o peor solo puede ganar el torneo si todos los demás individuos en el torneo tienen una aptitud de o peor. Esto significa que tenemos que calcular la probabilidad de que los individuos tengan una aptitud de o peor. Como la probabilidad de elegir un individuo con aptitud o peor está dada por , obtenemos:
Usando esta ecuación y la relación (ver Definición 2.2) obtenemos (4).
(4) muestra la fuerte influencia del tamaño del torneo en el comportamiento del esquema de selección. Obviamente, para obtenemos (en promedio) la distribución inicial sin cambios como:
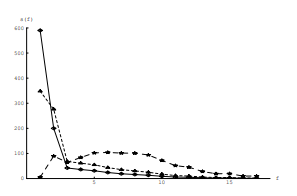
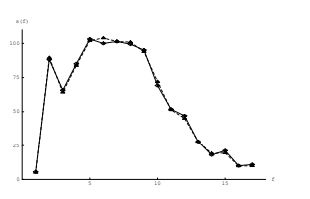
Como ejemplo de una distribución de aptitud (fitness) discreta, utilizamos la distribución de aptitud inicial del problema del "robot seguidor de paredes" de Koza [Koza, 1992]. Esta distribución es típica de los problemas resueltos mediante programación genética: existen muchos individuos malos (valor de aptitud 1) y solo unos pocos buenos (valor de aptitud 17). La Figura 1 muestra la distribución de aptitud inicial y las distribuciones resultantes para diferentes tamaños de torneo. En la Figura 2 se verifica la alta concordancia entre los resultados teóricos derivados y una simulación. Aquí se muestran las distribuciones de acuerdo a (4) y el promedio de 20 simulaciones.
-
-
-
-
Eje Y (): Frecuencia de individuos.
-
Eje X (): Valores de aptitud.
-
Descripción: Comparación entre la Distribución Teórica derivada (—) y la Simulación (- - -) para un Tamaño de Torneo . Se observa un ajuste casi perfecto entre ambas líneas.
-
-
-
-
Eje Y (): Frecuencia de individuos.
-
Eje X (): Valores de aptitud.
-
Descripción: Distribución de aptitud antes (—) y después de la Selección por Torneo con tamaño (- -) y (-- --). El tamaño de la población es .
En [Bäck, 1994], la probabilidad de que el individuo con rango sea seleccionado mediante selección por torneo se da como , bajo el supuesto de que los individuos están ordenados según su valor de aptitud . Nótese que Bäck utiliza una función de aptitud "invertida" donde el mejor individuo tiene el índice más bajo. Para comparar con nuestros resultados, transformamos la tarea en una de maximización usando :
Esta fórmula es un caso especial de (4) con todos los individuos teniendo un valor de aptitud diferente. Entonces para todo y , y produce la misma ecuación dada por Bäck. Nótese que esta fórmula no es válida si algunos individuos tienen el mismo valor de aptitud.
3.1 DESCRIPCIÓN USANDO DISTRIBUCIÓN CONTINUA
Ahora describiremos la distribución como una distribución continua , lo que permitirá derivar las siguientes propiedades de manera más sencilla. Para ello, asumimos valores de aptitud distribuidos continuamente. El rango de la función es , utilizando la misma notación que en el caso discreto.
Denotamos todas las funciones en el caso continuo con una barra, por ejemplo, escribimos en lugar de . Las sumas similares se reemplazan por integrales, por lo tanto:
denota la distribución de aptitud acumulada continua.
Teorema 3.2 Sea la distribución de aptitud continua de la población. Entonces la distribución de aptitud esperada después de realizar la selección por torneo con tamaño es:
Prueba: De forma análoga a la prueba del caso discreto, la probabilidad de que un individuo con aptitud o peor gane el torneo viene dada por:
Como , obtenemos (8).
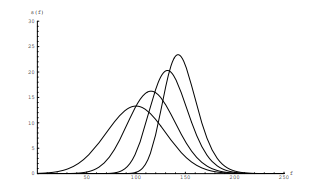
La Figura 3 muestra las distribuciones resultantes después del torneo si la distribución inicial es una distribución Gaussiana con .
distribución con y . Las distribuciones resultantes después del torneo con tamaños de torneo 2, 5 y 10 se muestran en la región de interés .
-
Eje Y (): Frecuencia de individuos.
-
Eje X (): Valores de aptitud (fitness).
-
Descripción: La distribución de aptitud Gaussiana conduce aproximadamente de nuevo a distribuciones Gaussianas tras el torneo. De izquierda a derecha: Distribución inicial; Distribución tras Selección por Torneo con tamaño .
4. PROPIEDADES DE LA SELECCIÓN POR TORNEO
4.1 CONCATENACIÓN DE FASES DE SELECCIÓN POR TORNEO
Una propiedad interesante de la selección por torneo es la concatenación de varias fases de selección. Supongamos una población arbitraria con la distribución de aptitud . Aplicamos primero una selección por torneo con tamaño a esta población y luego, sobre la población resultante, otra selección por torneo con tamaño (sin recombinación entre ellas). La distribución de aptitud obtenida es la misma que si se aplicara una sola selección por torneo con tamaño a la distribución inicial .
Teorema 4.1 Sea una distribución de aptitud y dos tamaños de torneo. Entonces se cumple la siguiente ecuación:
Prueba:
Como
podemos escribir
En [Goldberg y Deb, 1991] la proporción de los mejores individuos después de selecciones con tamaño de torneo (sin recombinación) se da por:
Esto puede obtenerse como un caso especial del Teorema 4.1.
Corolario 4.1 Sea una distribución de aptitud representable como:
con y . Entonces la distribución esperada tras el torneo con tamaño es:
Prueba: Si asumimos que es el resultado de aplicar la selección por torneo con tamaño sobre la distribución , (13) se obtiene directamente usando el Teorema 4.1.
relatedInteligencia Artificial