18. Lab Markov Chain
Una cadena de Markov (CM) es un tipo particular de proceso estocástico. Una CM tiene probabilidades de transición estacionarias, es decir, no dependen del tiempo. Las probabilidades del estado siguiente dependen únicamente del estado presente y no de los estados pasados.
Esto permite que la CM se pueda representar de manera compacata con un grafo. Por ejemplo:
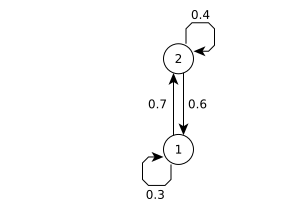 En este caso la CM tiene dos estados. Los parámetros de las aristas son las probabilidades de transición de estado.
Por ejemplo, en esta CM la probabilidad de transitar del estado 1 al estado 2 es de 0.7.
Esto lo denotamos como P(st+1=2∣st=1)=0.7.
Matrices y Cadenas de Markov
Las probabilidades de transición de una cadena de Markov se pueden representar de manera matricial. En este caso la matrix de probabilidades de transición T queda dada por:
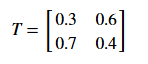 En python podemos utilizar el paquete científico numpy. La manera de representar esta matriz en Python es como sigue:
import numpy as np
T = np.matrix([[0.3,0.6],[0.7,0.4]])

print(T)
[[ 0.3 0.6]
[ 0.7 0.4]]
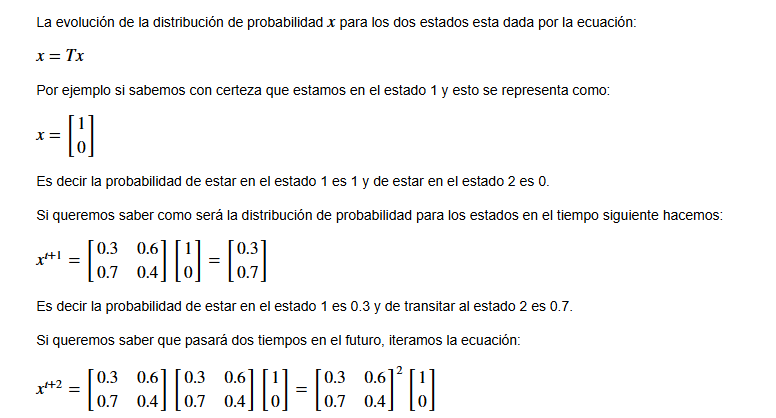
x = np.matrix([[1],[0]])
print('x =\n'+str(x))
x_1 = np.matmul(T,x)
print('x(t+1)=\n'+str(x_1))
x_2 = np.matmul(T,x_1)
print('x(t+2)=\n'+str(x_2))
x = [[1] [0]] x(t+1)= [[ 0.3] [ 0.7]] x(t+2)= [[ 0.51] [ 0.49]] Para comprobar que esto es lo mismo que elevar la matriz al cuadrado y multiplicar por podemos recurrir a la función matrix_power de numpy.
x_2 = np.matmul(np.linalg.matrix_power(T,2),x)
print('x(t+2)=\n'+str(x_2))
x(t+2)= [[ 0.51] [ 0.49]]
Bajo ciertas condiciones, existe una distribución de probabilidad estacionaria sobre los estados. Esto significa que no importa cual se la distribución de probabilidad inicial, al iterar la ecuación la distribución converge a una distribución que no cambia.
Por ejemplo definamos un método para encontrar la distribución de probabilidad al tiempo t dada una condición inicial x:
def calcula_dist(T,x_0,n):
    x_n = np.matmul(np.linalg.matrix_power(T,n),x_0)
    print('x(t+'+str(n)+')=\n'+str(x_n))
Usemos esta función para encontrar la distribución al tiempo 5:
x_5 = calcula_dist(T,x,5)

x(t+5)=
[[ 0.46023]
 [ 0.53977]]
Veamos como cambia la distribución con las primeras 10 iteraciones:
for i in range(10):

    calcula_dist(T,x,i)

x(t+0)=
[[ 1.]
 [ 0.]]
x(t+1)=
[[ 0.3]
 [ 0.7]]
x(t+2)=
[[ 0.51]
 [ 0.49]]
x(t+3)=
[[ 0.447]
 [ 0.553]]
x(t+4)=
[[ 0.4659]
 [ 0.5341]]
x(t+5)=
[[ 0.46023]
 [ 0.53977]]
x(t+6)=
[[ 0.461931]
 [ 0.538069]]
x(t+7)=
[[ 0.4614207]
 [ 0.5385793]]
x(t+8)=
[[ 0.46157379]
 [ 0.53842621]]
x(t+9)=
[[ 0.46152786]
 [ 0.53847214]]
Observamos una rápida convergencia a los valores.
¿Qué tanto tenemos que iterar la ecuación para encontrar la distribución?
Esto puede resolverse más fácilmente si observamos que lo que queremos encontrar es x* tal que:
x=Tx**
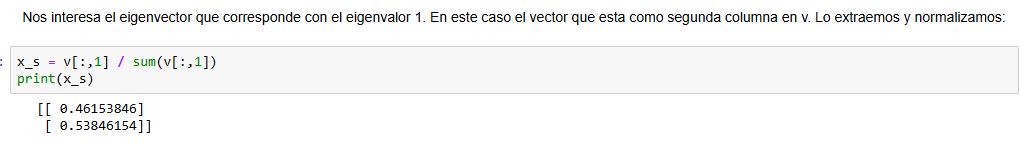
Esto es equivalente a resolver el problema de encontrar los vectores característicos de la matriz T.
Los vectores característicos de una matriz son aquellos que no cambian de dirección cuando se aplica la transformación lineal T (es decir cuando se multiplica por T).
En numpy podemos encontrar esto usando linalg.eig
l,v = np.linalg.eig(T)
print(l)
print(v)
relatedInteligencia Artificial