Sea Level Predictor
Sea Level Predictor es un proyecto de análisis y regresión lineal desarrollado como parte de la certificación Data Analysis with Python de freeCodeCamp. El objetivo es estudiar la evolución histórica del nivel del mar y construir dos líneas de tendencia:
- Una regresión basada en todo el registro disponible.
- Una regresión basada únicamente en los datos desde el año 2000.
Ambas líneas se extienden hasta 2050 para estimar visualmente cómo podría continuar el aumento del nivel del mar. El proyecto no pretende producir una predicción científica completa: es un ejercicio de análisis exploratorio, regresión lineal y visualización con Python.
Repositorio original: AudiForze/freecodecamp/Sea Level Predictor.
Tecnologías
- Python: implementación del análisis.
- Pandas: lectura y manipulación del CSV.
- Matplotlib: dispersión, líneas de tendencia y exportación de la figura.
- SciPy: cálculo de regresión lineal mediante
linregress. - unittest: pruebas automatizadas sobre la figura y sus datos.
Estructura
Sea Level Predictor/
├── epa-sea-level.csv
├── sea_level_predictor.py
├── sea_level_plot.png
└── test_module.py
El CSV contiene los años y la columna CSIRO Adjusted Sea Level. El PNG es la salida visual del script. test_module.py verifica que la gráfica cumpla la estructura solicitada por el ejercicio.
Dataset y variables
El programa lee el dataset con Pandas:
df = pd.read_csv("Sea Level Predictor/epa-sea-level.csv")
Las columnas fundamentales son:
Year: año de la observación.CSIRO Adjusted Sea Level: nivel del mar ajustado, medido en pulgadas.
La variable independiente es el año y la variable dependiente es el nivel del mar. El análisis trabaja con los datos tal como aparecen en el archivo y no realiza una conversión adicional de unidades.
Flujo de procesamiento
La función pública draw_plot() concentra todo el pipeline:
CSV
 ↓
DataFrame de Pandas
 ↓
Scatter plot de observaciones históricas
 ↓
Regresión lineal sobre todo el dataset
 ↓
Regresión lineal desde 2000
 ↓
Extensión de ambas líneas hasta 2050
 ↓
Archivo sea_level_plot.png
La función devuelve el eje (Axes) de Matplotlib, lo que permite que las pruebas inspeccionen títulos, etiquetas, puntos y líneas sin tener que leer una imagen manualmente.
Gráfico de observaciones y regresiones
Primero se dibuja cada observación como un punto:
plt.figure(figsize=(10, 6))
plt.scatter(df["Year"], df["CSIRO Adjusted Sea Level"])
Después se calcula la regresión con todos los años:
res = linregress(
    df["Year"],
    df["CSIRO Adjusted Sea Level"],
)
x_pred = pd.Series(range(1880, 2051))
y_pred = res.intercept + res.slope * x_pred
plt.plot(x_pred, y_pred, color="red")
La ecuación utilizada es la forma clásica de una recta:
nivel estimado = intercepto + pendiente * año
La pendiente representa el cambio lineal estimado del nivel del mar por año dentro del conjunto analizado.
Tendencia reciente
El proyecto calcula una segunda regresión con las observaciones desde el año 2000:
df_recent = df[df["Year"] >= 2000]
res_recent = linregress(
    df_recent["Year"],
    df_recent["CSIRO Adjusted Sea Level"],
)
x_pred_recent = pd.Series(range(2000, 2051))
y_pred_recent = res_recent.intercept + res_recent.slope * x_pred_recent
plt.plot(x_pred_recent, y_pred_recent, color="green")
La separación es importante porque una tendencia histórica completa y una tendencia reciente pueden tener pendientes diferentes. El gráfico permite comparar visualmente ambas hipótesis:
- Línea roja: tendencia desde 1880.
- Línea verde: tendencia desde 2000.
- Puntos: mediciones observadas.
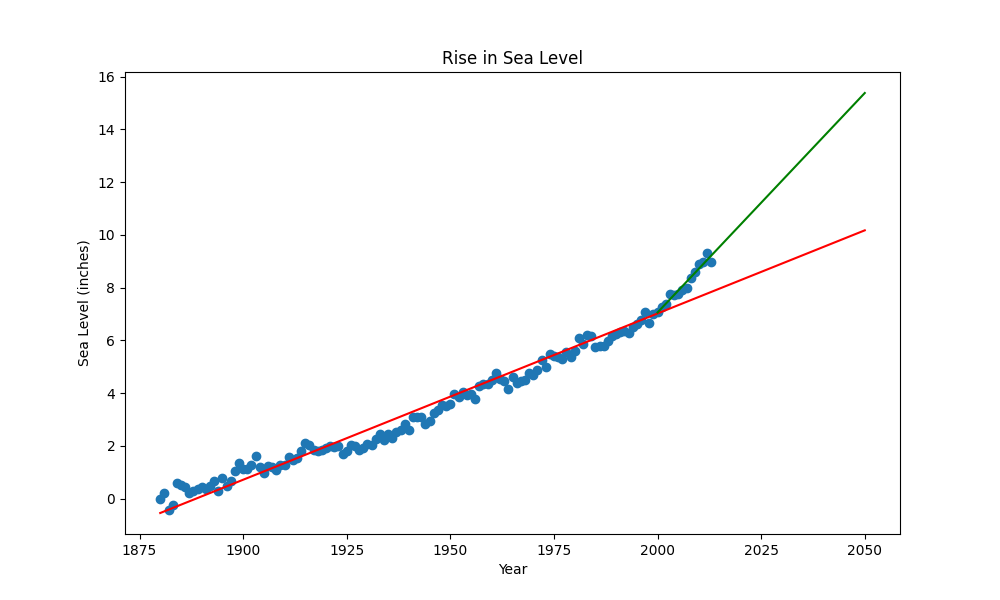
La imagen se conserva localmente en public/img/sea-level-predictor/sea_level_plot.png, a partir de la salida original del repositorio.
Configuración visual
El resultado final se etiqueta así:
plt.xlabel("Year")
plt.ylabel("Sea Level (inches)")
plt.title("Rise in Sea Level")
plt.savefig("sea_level_plot.png")
Estas etiquetas hacen explícito qué representa cada eje y qué unidad utiliza la medición. El tamaño 10 x 6 ofrece una proporción adecuada para mostrar varios años y las dos líneas de regresión.
Pruebas automatizadas
test_module.py utiliza unittest y comprueba la salida de draw_plot().
Título y etiquetas
def test_plot_title(self):
    actual = self.ax.get_title()
    expected = "Rise in Sea Level"
    self.assertEqual(actual, expected)
También se verifican:
- Eje X:
Year. - Eje Y:
Sea Level (inches). - Ticks del eje X entre 1850 y 2075.
Puntos de datos
La prueba inspecciona los offsets del primer objeto gráfico para comprobar que los puntos históricos corresponden al dataset esperado:
actual = self.ax.get_children()[0].get_offsets().data.tolist()
Esto es más estricto que comprobar únicamente que exista un scatter plot: también verifica los valores utilizados para construirlo.
Líneas de regresión
La figura debe contener las dos líneas previstas. Las pruebas comparan sus valores Y con los resultados esperados de la regresión completa y de la regresión reciente:
actual = self.ax.get_lines()[0].get_ydata().tolist()
np.testing.assert_almost_equal(actual, expected, 7)
El uso de assert_almost_equal es adecuado para números de coma flotante, donde una comparación exacta puede fallar por pequeñas diferencias de representación.
Ejecución local
Instala las dependencias:
pip install pandas matplotlib scipy numpy
Desde la raíz del repositorio:
python "Sea Level Predictor/sea_level_predictor.py"
Para ejecutar las pruebas:
python -m unittest "Sea Level Predictor/test_module.py"
El script utiliza una ruta relativa al CSV, por lo que conviene ejecutarlo desde la raíz de freecodecamp.
Análisis técnico
Fortalezas
- Utiliza una función de regresión apropiada para un análisis lineal sencillo.
- Compara una tendencia de largo plazo con una tendencia reciente.
- Separa los datos observados de las líneas estimadas mediante colores distintos.
- Devuelve el objeto de Matplotlib para facilitar las pruebas.
- Las pruebas inspeccionan contenido real de la figura, no solo que el programa termine.
- El alcance está bien delimitado: una fuente tabular, dos modelos lineales y una gráfica reproducible.
Limitaciones
- Una regresión lineal no captura necesariamente aceleraciones, cambios de régimen ni factores climáticos complejos.
- El resultado es una extrapolación matemática, no una predicción científica del futuro.
- No se calculan ni se muestran intervalos de confianza, error estándar,
r-valueop-value. - La función no devuelve los coeficientes de las regresiones para permitir un análisis cuantitativo posterior.
- La ruta del CSV está fija y depende del directorio de ejecución.
- No se parametrizan el año inicial, el año de corte ni el año final de predicción.
- La figura no incluye una leyenda que identifique formalmente cada línea.
Mejoras posibles
- Devolver los objetos de regresión y mostrar sus pendientes.
- Añadir una leyenda para distinguir las líneas histórica y reciente.
- Incorporar bandas de confianza.
- Comparar regresión lineal con modelos polinómicos o series temporales.
- Parametrizar el año de corte y el horizonte de predicción.
- Añadir validación de columnas y mensajes claros si falta el CSV.
- Usar
pathlibpara resolver rutas de forma independiente del directorio actual. - Añadir un
requirements.txtopyproject.tomlcon versiones reproducibles.
Qué demuestra el proyecto
Este ejercicio demuestra un flujo compacto pero completo de análisis de datos:
- Lectura de un dataset real.
- Selección de variables cuantitativas.
- Visualización de observaciones.
- Ajuste de modelos lineales.
- Extrapolación controlada.
- Exportación de resultados.
- Pruebas automatizadas sobre una figura científica.
El valor pedagógico está en comparar dos ventanas temporales y observar cómo la elección del periodo de entrenamiento cambia la tendencia estimada.