Page View Time Series Visualizer
Este proyecto fue desarrollado como parte de la certificación de Data Analysis with Python de freeCodeCamp. Su objetivo es analizar el número de visitas diarias del foro de freeCodeCamp entre mayo de 2016 y diciembre de 2019, limpiar los datos y representarlos mediante tres visualizaciones estadísticas:
- Una serie temporal de visitas diarias.
- Un gráfico de barras con el promedio mensual agrupado por año.
- Dos diagramas de caja para estudiar tendencias anuales y estacionalidad mensual.
El repositorio original está disponible en AudiForze/freecodecamp.
Tecnologías utilizadas
- Python: lenguaje principal.
- Pandas: lectura, limpieza, transformación y agrupación del dataset.
- Matplotlib: creación de figuras, ejes, etiquetas y exportación de imágenes.
- Seaborn: gráficos estadísticos de barras y cajas.
- unittest: pruebas automatizadas del procesamiento y las visualizaciones.
- CSV: fuente de datos con la fecha y el número de visitas.
Estructura del proyecto
page-view-time-series-visualizer/
├── fcc-forum-pageviews.csv
├── time_series_visualizer.py
├── test_module.py
├── line_plot.png
├── bar_plot.png
├── box_plot.png
└── __pycache__/
El archivo __pycache__ es generado por Python y no forma parte de la lógica del análisis. Los archivos PNG son resultados exportados por el script y permiten revisar las gráficas sin ejecutar nuevamente el programa.
Dataset
El archivo fcc-forum-pageviews.csv contiene dos columnas principales:
date: fecha de la observación.value: cantidad de visitas del foro durante ese día.
El código utiliza la fecha como índice y la convierte directamente a objetos temporales de Pandas:
df = pd.read_csv(
    'page-view-time-series-visualizer/fcc-forum-pageviews.csv',
    index_col='date',
    parse_dates=True,
)
El dataset original contiene 1.303 filas de datos. La certificación pide eliminar los valores extremos para que unos pocos días anómalos no distorsionen las gráficas. El proyecto conserva los valores entre los percentiles 2,5 y 97,5:
df = df.dropna()
df = df[
    (df['value'] >= df['value'].quantile(0.025))
    & (df['value'] <= df['value'].quantile(0.975))
]
Después de esta limpieza quedan 1.238 observaciones, valor que también es comprobado por las pruebas automatizadas.
Por qué se eliminan los valores extremos
La eliminación no pretende borrar información útil de forma arbitraria. En este contexto se busca representar el comportamiento habitual del foro. Un aumento excepcional de tráfico puede hacer que la escala de la gráfica o los promedios oculten las tendencias más frecuentes.
La estrategia aplicada es un filtrado estadístico por cuantiles:
- Se calcula el percentil 2,5 como límite inferior.
- Se calcula el percentil 97,5 como límite superior.
- Se mantienen los registros dentro de ese intervalo.
Esta decisión debe documentarse porque modifica el conjunto de datos utilizado por todas las gráficas posteriores.
Arquitectura del código
El archivo time_series_visualizer.py tiene una pequeña capa de preparación de datos y tres funciones públicas de visualización:
Carga del CSV
    ↓
Conversión de fechas y limpieza
    ↓
DataFrame global df
    ├── draw_line_plot()
    ├── draw_bar_plot()
    └── draw_box_plot()
El DataFrame limpio se prepara al importar el módulo. Las funciones reciben los datos desde ese df, crean una figura de Matplotlib, configuran sus ejes y guardan el resultado en un archivo PNG. Cada función también devuelve el objeto Figure, lo que permite probar sus elementos sin tener que inspeccionar manualmente una imagen.
Visualización 1: serie temporal
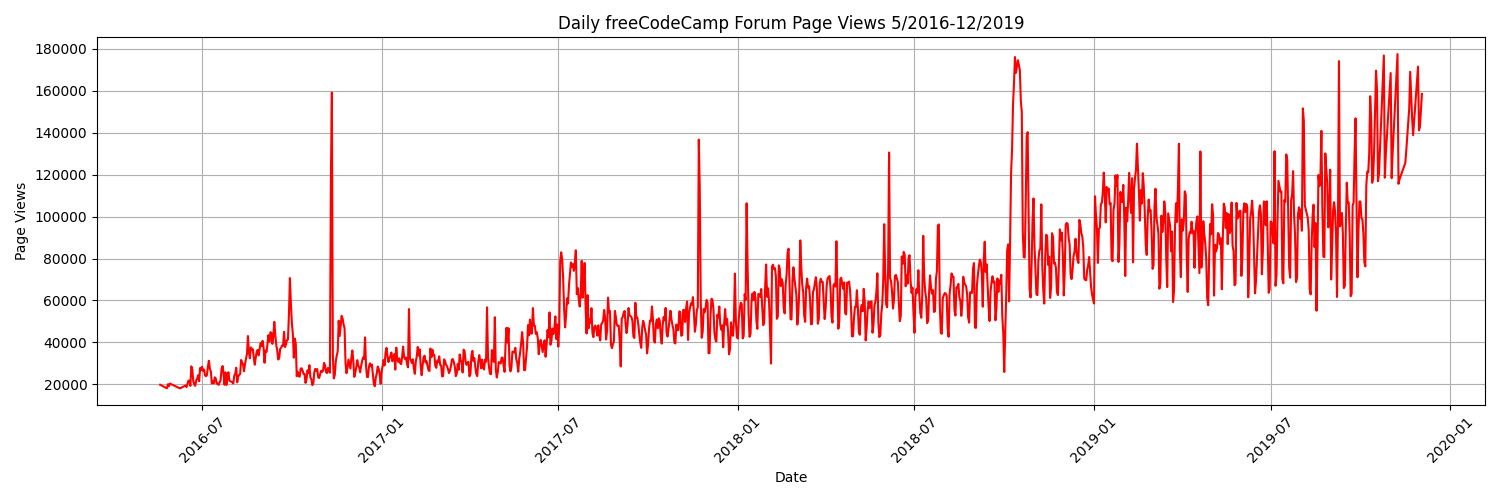
draw_line_plot() muestra la evolución diaria de las visitas entre 2016 y 2019.
def draw_line_plot():
    fig, ax = plt.subplots(figsize=(15, 5))
    ax.plot(df.index, df['value'], color='red')
    ax.set_xlabel('Date')
    ax.set_ylabel('Page Views')
    ax.set_title('Daily freeCodeCamp Forum Page Views 5/2016-12/2019')
    ax.grid(True)
    plt.xticks(rotation=45)
    plt.tight_layout()

    fig.savefig('line_plot.png')
    return fig
Esta gráfica es la más adecuada para observar cambios a lo largo del tiempo. Permite identificar periodos de crecimiento, descensos prolongados y variaciones diarias. El eje horizontal representa las fechas y el eje vertical la cantidad de visitas.
Decisiones técnicas
figsize=(15, 5)proporciona espacio horizontal para muchas fechas.- La rotación de las etiquetas evita que se superpongan.
grid(True)facilita seguir los valores sobre el eje vertical.tight_layout()reduce los recortes de títulos y etiquetas al guardar la figura.- La figura se guarda como
line_plot.pngpara hacer el resultado reproducible.
Visualización 2: promedio mensual por año
El gráfico de barras compara el promedio diario de visitas de cada mes a través de los años. Para construirlo, el índice temporal se devuelve a una columna y se extraen el año y el número de mes:
df_bar = df.copy()
df_bar.reset_index(inplace=True)
df_bar['year'] = [d.year for d in df_bar.date]
df_bar['month'] = [d.month for d in df_bar.date]
Después, Seaborn agrupa los datos con el año en el eje horizontal, el valor promedio en el eje vertical y el mes como categoría de color:
sns.barplot(
    x='year',
    y='value',
    data=df_bar,
    hue='month',
    palette='bright',
    ax=ax,
)
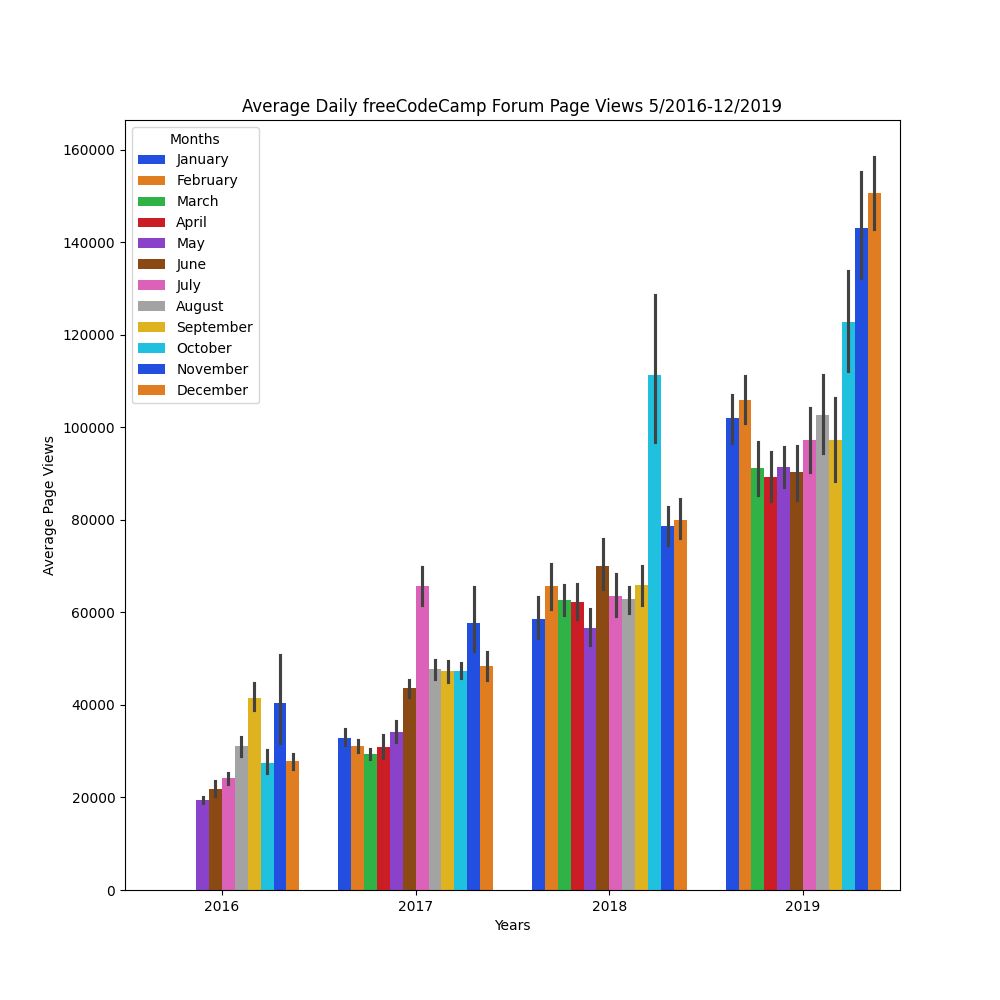
La leyenda se reemplaza con nombres completos de los meses para que el gráfico sea más comprensible:
labels = [
    'January', 'February', 'March', 'April', 'May', 'June',
    'July', 'August', 'September', 'October', 'November', 'December',
]
for text, label in zip(ax.legend(loc='upper left', title='Months').texts, labels):
    text.set_text(label)
Este gráfico sirve para comparar dos dimensiones al mismo tiempo:
- Tendencia interanual: si los promedios crecen o disminuyen entre 2016, 2017, 2018 y 2019.
- Comportamiento mensual: si ciertos meses tienden a concentrar más o menos tráfico.
El proyecto genera 49 barras porque 2016 comienza en mayo y 2019 termina en diciembre; no existen doce meses completos para todos los años.
Visualización 3: diagramas de caja
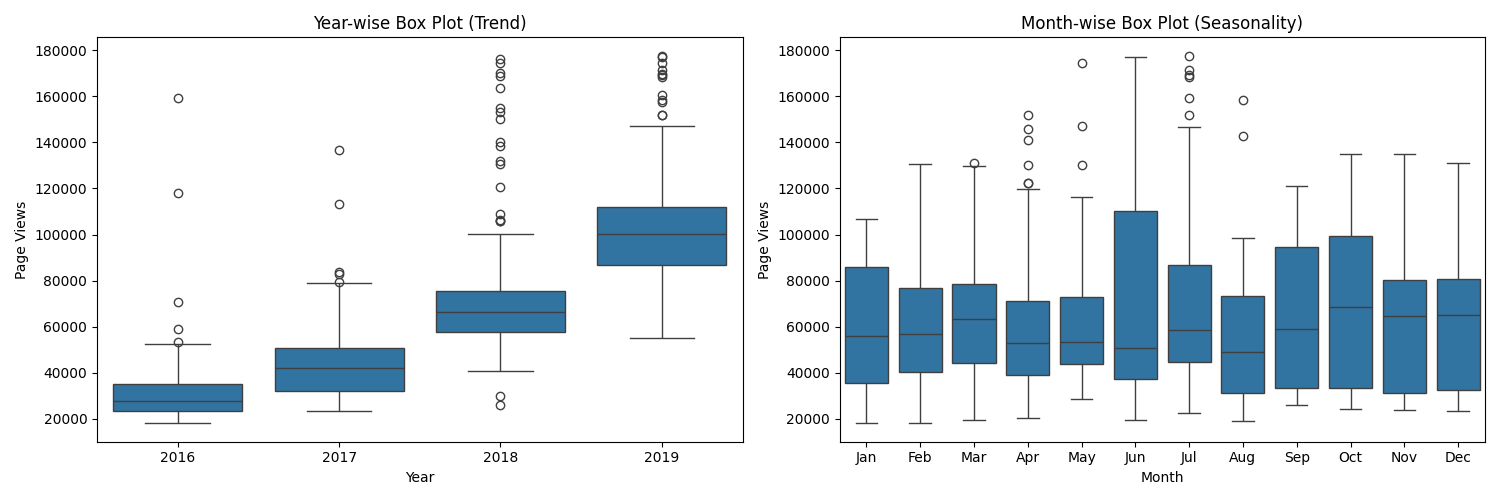
draw_box_plot() crea dos diagramas dentro de una misma figura:
- Un diagrama por año para estudiar la tendencia.
- Un diagrama por mes para estudiar la estacionalidad.
df_box = df.copy()
df_box.reset_index(inplace=True)
df_box['year'] = [d.year for d in df_box.date]
df_box['month'] = [d.strftime('%b') for d in df_box.date]

fig, ax = plt.subplots(nrows=1, ncols=2, figsize=(15, 5))
El primer panel agrupa por año:
sns.boxplot(x='year', y='value', data=df_box, ax=ax1)
ax1.set_xlabel('Year')
ax1.set_ylabel('Page Views')
ax1.set_title('Year-wise Box Plot (Trend)')
El segundo agrupa por abreviatura de mes:
sns.boxplot(x='month', y='value', data=df_box, ax=ax2)
ax2.set_xlabel('Month')
ax2.set_ylabel('Page Views')
ax2.set_title('Month-wise Box Plot (Seasonality)')
Cómo leer estos diagramas
Cada caja resume la distribución de visitas de un grupo:
- La línea central representa la mediana.
- La caja representa el rango intercuartílico.
- Los bigotes muestran la dispersión esperada fuera de la caja.
- Los puntos alejados pueden representar observaciones atípicas dentro del conjunto ya filtrado.
El panel anual permite comparar la distribución completa de cada año, no solo el promedio. El panel mensual permite observar si determinados meses presentan una mediana o una variabilidad sistemáticamente distinta.
Pruebas automatizadas
test_module.py utiliza unittest para comprobar tanto el procesamiento como la estructura de las figuras. No se limita a verificar que el script se ejecute: inspecciona títulos, etiquetas, cantidad de ejes, número de datos y elementos gráficos.
Limpieza de datos
class DataCleaningTestCase(unittest.TestCase):
    def test_data_cleaning(self):
        actual = int(time_series_visualizer.df.count(numeric_only=True))
        expected = 1238
        self.assertEqual(actual, expected)
Esta prueba protege una regla fundamental del proyecto: el dataset limpio debe contener 1.238 observaciones.
Pruebas de la serie temporal
Las pruebas verifican que:
- El título sea
Daily freeCodeCamp Forum Page Views 5/2016-12/2019. - El eje X se llame
Date. - El eje Y se llame
Page Views. - La línea tenga 1.238 puntos.
def test_line_plot_data_quantity(self):
    actual = len(self.ax.lines[0].get_ydata())
    expected = 1238
    self.assertEqual(actual, expected)
Pruebas del gráfico de barras
Se comprueba que la leyenda tenga los doce meses en inglés, que los ejes sean correctos, que aparezcan los años 2016 a 2019 y que el gráfico tenga 49 barras.
Pruebas de los diagramas de caja
El módulo verifica que existan dos ejes y que cada panel tenga el significado esperado:
- Cuatro cajas anuales.
- Doce cajas mensuales.
- Títulos de tendencia y estacionalidad.
- Etiquetas de meses abreviadas.
- Escala vertical esperada en el primer panel.
Estas comprobaciones son útiles porque una visualización puede generarse sin errores de Python y, aun así, tener etiquetas incorrectas o agrupar los datos de forma equivocada.
Flujo completo de ejecución
El proceso de análisis puede resumirse así:
- Leer el CSV con Pandas.
- Interpretar
datecomo fecha y usarla como índice. - Eliminar valores nulos.
- Calcular los cuantiles 0,025 y 0,975.
- Filtrar los valores extremos.
- Crear la serie temporal diaria.
- Crear columnas auxiliares de año y mes.
- Generar promedios mensuales por año.
- Generar distribuciones anuales y mensuales.
- Guardar las tres figuras en PNG.
- Ejecutar las pruebas automatizadas.
Ejecución local
Desde la raíz del repositorio freecodecamp se pueden instalar las dependencias y ejecutar el script:
pip install pandas matplotlib seaborn
python page-view-time-series-visualizer/time_series_visualizer.py
Para ejecutar las pruebas desde la carpeta del proyecto:
cd page-view-time-series-visualizer
python -m unittest test_module.py
El script utiliza una ruta relativa hacia el CSV:
'page-view-time-series-visualizer/fcc-forum-pageviews.csv'
Por eso conviene ejecutarlo desde la raíz del repositorio, o adaptar la ruta si se ejecuta estando dentro de la carpeta del proyecto.
Análisis técnico
Fortalezas
- La preparación de datos es corta y fácil de seguir.
- Se usa Pandas para trabajar correctamente con fechas e índices temporales.
- Las tres gráficas responden preguntas diferentes: evolución, comparación y distribución.
- Los resultados se exportan a archivos reproducibles.
- Las pruebas validan tanto valores como metadatos visuales.
- El proyecto separa la lógica de cada gráfica en funciones independientes.
Aspectos mejorables
- La ruta del CSV está escrita de forma fija y depende del directorio desde donde se ejecute el script.
- El nombre
dfes válido, pero una función de carga y limpieza haría más explícito el flujo. - La creación de las columnas
yearymonthpodría utilizar las propiedades.dt.yeary.dt.monthde Pandas. set_xticklabels()puede generar advertencias en versiones recientes de Matplotlib si no se configuran explícitamente las posiciones de las marcas.- Las etiquetas y títulos están en inglés, coherentes con el reto de freeCodeCamp, aunque una versión orientada a usuarios hispanohablantes podría internacionalizarlos.
- Sería útil añadir un archivo
requirements.txtopyproject.tomlpara fijar versiones. - El directorio
__pycache__debería excluirse mediante.gitignore. - Las pruebas podrían comprobar también que los archivos PNG se creen correctamente y que la figura se cierre después de guardarla.
Qué demuestra este proyecto
Este trabajo demuestra un flujo completo de análisis exploratorio y visualización de datos:
- Importación de datos tabulares.
- Conversión y manipulación de fechas.
- Tratamiento básico de valores nulos y extremos.
- Comparación de medias por categorías temporales.
- Análisis de tendencias y estacionalidad.
- Comunicación de resultados mediante visualizaciones.
- Automatización de verificaciones con pruebas unitarias.
La parte más importante no es solo dibujar tres gráficos. Es elegir una representación adecuada para cada pregunta: la línea explica el cambio diario, las barras permiten comparar promedios y los diagramas de caja muestran la distribución y la variabilidad.